
超出期待,需要多少人类时间?
 作者 Evanchen
我想从两个典型案例说起:《复联 4》最后的报幕,和 PUBG 背后的制作环节。
这两个案例让我想讨论,为什么群体的 agent 还很难胜任这样的工作,以及人类需要在哪些环节投入时间。
电影工程:《复联 4》的片尾名单
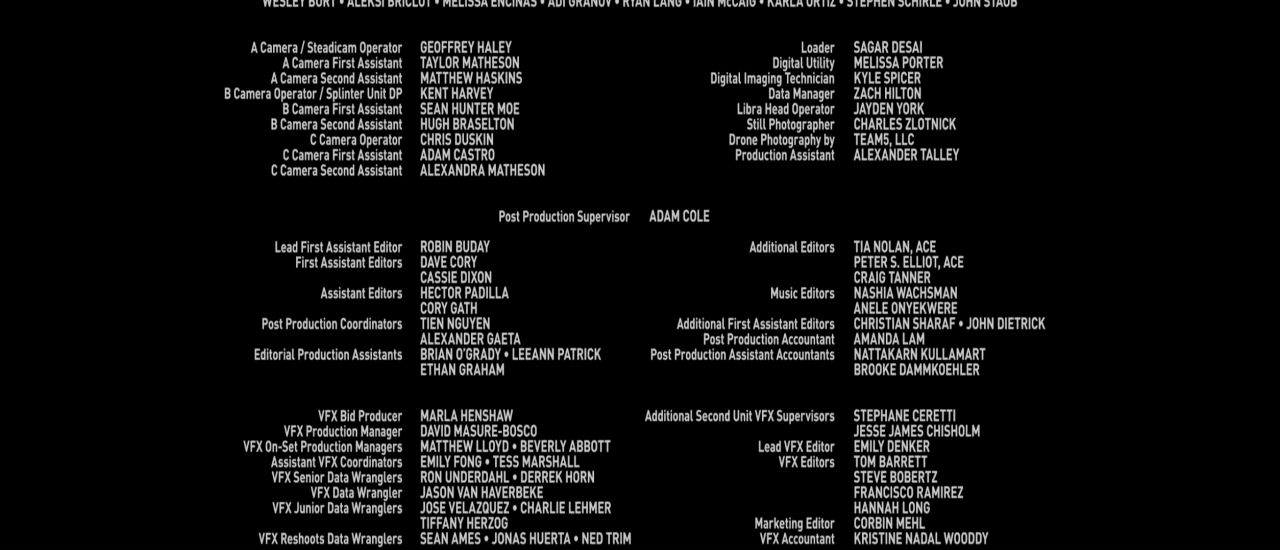
《复联 4》最后的报幕,展示了一个史诗级的人类艺术文明明珠,是如何把复杂问题分而治之的:拆解成各个组成部分以后,在哪些环节投入了必要的人类 align 时间,最终加工出这种水准的工艺。
导演、编剧、摄影、美术、服装、视觉特效、剪辑、音乐,名单一直往下滚。每一行后面,都是一段被投入进去的人类时间。
你可以把它叫做“电影工程”。
这非常依赖 the first one 的整体编排和资源筹集能力,也就是那个把方向定下来、把资源拢起来的人或者核心班底。因为组织起来的都是异构资源:人员来自不同文化背景、专业和过往经历,再通过电影工业的制作工序形成艺术,中间产生了大量的随机碰撞。
PUBG:每一个可能被用户看到的细节
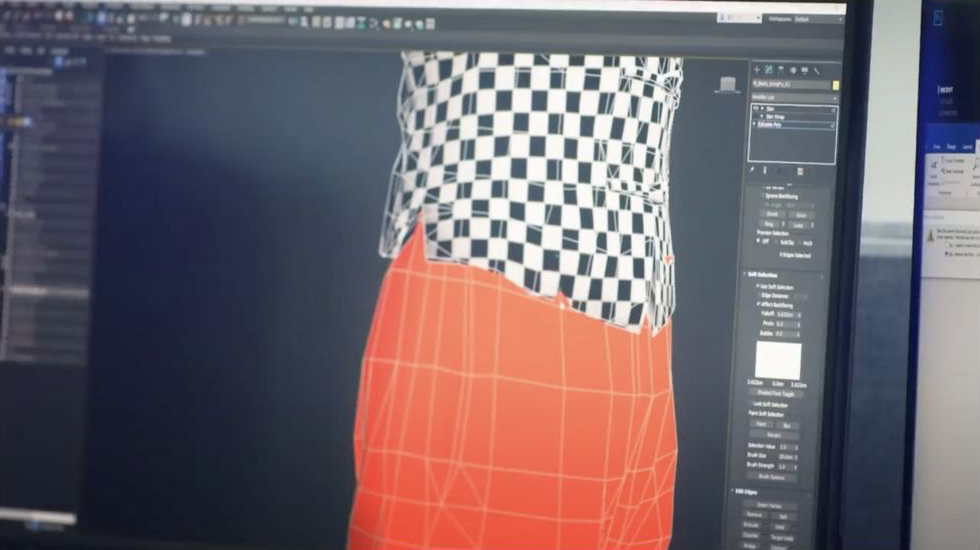
游戏也一样。蓝洞在运营和开发 PUBG 的过程中,拆解出了大量角色和要素,而且要在每一个可能被用户看到的细节上做拆解。
一张地图不只是地形:房子怎么摆,哪里能藏,哪里必须冒险。脚步声从哪个方向来,枪声隔着多远,玩家会把看到、听到的东西,变成自己的判断。
在 PUBG 官方的 Vikendi 制作幕后里,团队讨论的是如何让雪“感觉像雪”,不同地表材质怎么改变车辆的表现。连迷彩服装,也要放回雪地环境里考虑。到了每周五的 Playday,整个办公室一起试玩,再把这些局部放回一个完整体验里。
再往下,是服务器、反作弊、版本运营。这些东西玩家看不见,可一旦卡顿、一旦外挂泛滥,前面所有看得见的东西会一起塌掉。
clean context 的 agent,不够 different
Agent 可以做很难的数学,比如 OpenAI 展示过的数学推理,把更多计算花在推理和解题上。但组织电影、游戏这种作品,还有两件事。
第一,在一类常见的多 Agent 编排里,拆分出来的 SubAgent 拿到一个相对独立的 clean context(干净上下文)。它拥有我所说的首发注意力:先聚焦这个 prompt,前面没有一长串历史来分散它,并与主 long-term task 的大段上下文隔离开。
所以拿它去解决效率问题,或者数学、材料、蛋白质研究里那些已经有明确约束、能检查结果的子问题,是很有价值的。这些领域也需要洞察和创造力,但当问题能够被尝试、被验证时,什么叫进展,就比较容易判断。
这时候你会感觉,实际工作进度往往就跟着 token 开销走,也就是堆砌的智能 token 总量。当然还得有工具反馈和验证,否则也可能一直空转。
第二,clean context 的 agent 并没有因为上下文干净,就完成了“异化”。它仍然可能不够 different。
你可以给一群 agent 分别写上“你是导演”“你是编剧”“你是摄影指导”,但如果底下还是同一个模型、同一套先验,写进 prompt 的角色,并不会自带一个人几十年的文化背景、专业和过往经历。
人工也很难只靠编制角色 prompt,就编制出有序的 different。哪怕能搞出类似“无限猴子”的随机 different,也没有意义。它们必须是有序的、符合人类社会期待的对齐。
有效偏离,和两种目标函数
还有一个逻辑也是非常 make sense 的,一些底层逻辑吧:目标函数。
艺术或者说审美,很多时候就源自于某种小众的流派,或者说没有那么通俗。当然也有一些雅俗共赏的艺术,但你可以理解为,大多数情况下被称之为艺术的,大概率是对均值的某种偏差,或者是方差比较大的一些离群点。
你在制作一个电影或者制作一个游戏的时候,最重要的部分不是无限去堆砌这种离群点,而是要合理地去编排它们。
这些离群点,可能体现在电影工程和游戏工程里:不同角色的分工、合作、工作流、随机碰撞,甚至是茶水间聊天碰撞出的一些 idea。它们是在这些很混沌的系统里面产生的一些有效偏离。而这些有效偏离,其实是把一个庸俗的作品变成杰作(masterpiece)的关键。
但是对于 engineer 来说,很多看不见的 decision 和判断,反而更接近均值回归:优先用已经被验证过的办法,不太需要那么多的离群点。
我没有说哪一方是要堆砌极端的离群点,但对于 engineer 来说,他需要的是严谨,需要大多数情况下 work、stable、鲁棒。所以很多 agent 的工程直觉很棒,你在那边不需要让它去刻意离群。
这就是 difference:一个是效率,一个是 emotion(情绪);一个偏向于艺术,一个偏向于 engineer figure out。哪怕在同一个 PUBG 里,服务器和反作弊优先解决可靠性,决赛圈那种紧张感是 emotion。这也是本质上两种不同的目标函数,很难去量化。
一句话生成,省略了哪些环节
回到前面,我认为“一句话生成一部电影或者一个游戏”,还不能作为稳定产出精品的方法成立。
一部电影,从剧本、分镜、拍摄、特效到剪辑,每一个环节都是一次重新描述、加工和编排,每一次都有人在 align。只看一句话和最终结果,很容易把中间的环节全都隐藏掉。
描述、加工和编排环节过少,意味着大量你没说的部分,要由模型自己填。我的担心是,这些 output 容易落到一种统计上常见、熟悉、没什么问题,但也没有那么 different 的选择上。
一句话没有交代的海量 decision,仍然需要在制作过程中补上,再经过编排、筛选和反馈。
所以,要有方向地做到这种水准,就需要把它拆成不同环节,在关键地方投入必要的人类劳动时间,并让这些判断最终成为用户能感受到的东西。
那图片呢?
这里有一个看起来矛盾的地方:图片、画作等同属艺术领域的内容,为什么只需要人类极短的必要劳动时间投入,就能很好地与人 align?
这也经历过一个过程,就像最初的“威尔·史密斯吃面”一样。而视频生成会经历一段更有意思的发展,因为视频的信息量极大:人物要前后一致,镜头在动,动作有因果,前一秒和后一秒要接得上。写下一条公式可能只需要很少的符号,但要准确 describe 一个具体视频却极难。难的是把画面、动作、节奏和前后关系同时说清楚。比如给它一张参考图片,其实就已经补充了海量的信息比特。
给它 few-shot example,也是在补充这种很难用一句话说清楚的信息。无论是语言模型,还是 Stable Diffusion 这类图像生成模型,架构、训练、参数和条件输入,都会影响它能从参考里利用多少信息。
我不确定不同异构的模型,是否都符合“压缩即智能”这一种说法。但输入中与目标有关、能被模型利用的信息越丰富,就越有机会产出与人类期待对齐的 output。
区别在于:对“被隐藏部分”的容忍度
我们探讨图片生成、视频生成,与游戏、电影这种更长程的 long-term task 制作之间的区别,核心在于:不同领域对“被隐藏部分”的容忍度完全不同。
一张图里没说清楚的部分,模型替你补了,补得像样你就收下;不满意,扫一眼换一张。人类投入的时间这么短,一方面是模型已经懂了很多,另一方面是我们允许它替我们决定很多。
长程的作品容忍不了这么多隐藏。概念图里的门,可能只需要像一扇门;游戏里的门,还要回答能不能打开、怎么碰撞、能不能挡住视线。电影里的一个动作,也要在后面的情节里有自己的位置。在局部可以被默认填掉的选择,放进一个长程作品里,就会互相牵动。
视频已经开始碰到这个问题:前一秒被默认填掉的东西,后一秒就得接住。到了电影和游戏,这种牵动会从几秒钟,拉长到几个小时、一整张地图。
更麻烦的是,被隐藏的部分,人自己一开始也看不清。
比如一个工程师在描述复杂软件工程任务时,往往不是自己已经有一份非常完善的 spec,再纯交给 agent 执行,更多是边想边做。他一开始也需要做 POC,很多细节并不清晰,对整个迷雾的探索,大概只能凭借过往经验、个人 intelligence 以及市面上的参考,剥离 40% 到 50%,这是我的体感。
在面临如何准确提供任务全集信息输入、使其符合人类期待时,如果能直接给一个 repo 或 example 作为参考,问题就会简单很多,因为这补充了大量能够有效引导 attention 的输入 token。
电影里的参考片、分镜,游戏里的可玩原型,干的也是同一件事。但参考只能帮你剥掉一部分迷雾,剩下的,还得在做的过程中一点点拆、一点点 align。
被看见
“被看见”是贴合社会舆情和群体情绪、做营销非常重要的一点。它必须超出人们的期待。体感上,不是好 1.1 倍、1.2 倍,而是 3 倍、5 倍甚至 10 倍。
比如在人类理解中,投入了 3 到 5 天,产出的却是 30 天水准的作品,那个超出群体期待的落差,会让人想转给别人看。电影和游戏这类艺术精品,解决的都是效率之外更高层次的精神享受。
这里可以把人类必要劳动时间分成两种:被看得见的,和看不见的。PUBG 里那扇门、那串脚步声,《复联 4》里的每一个镜头,都是被看得见的那种。
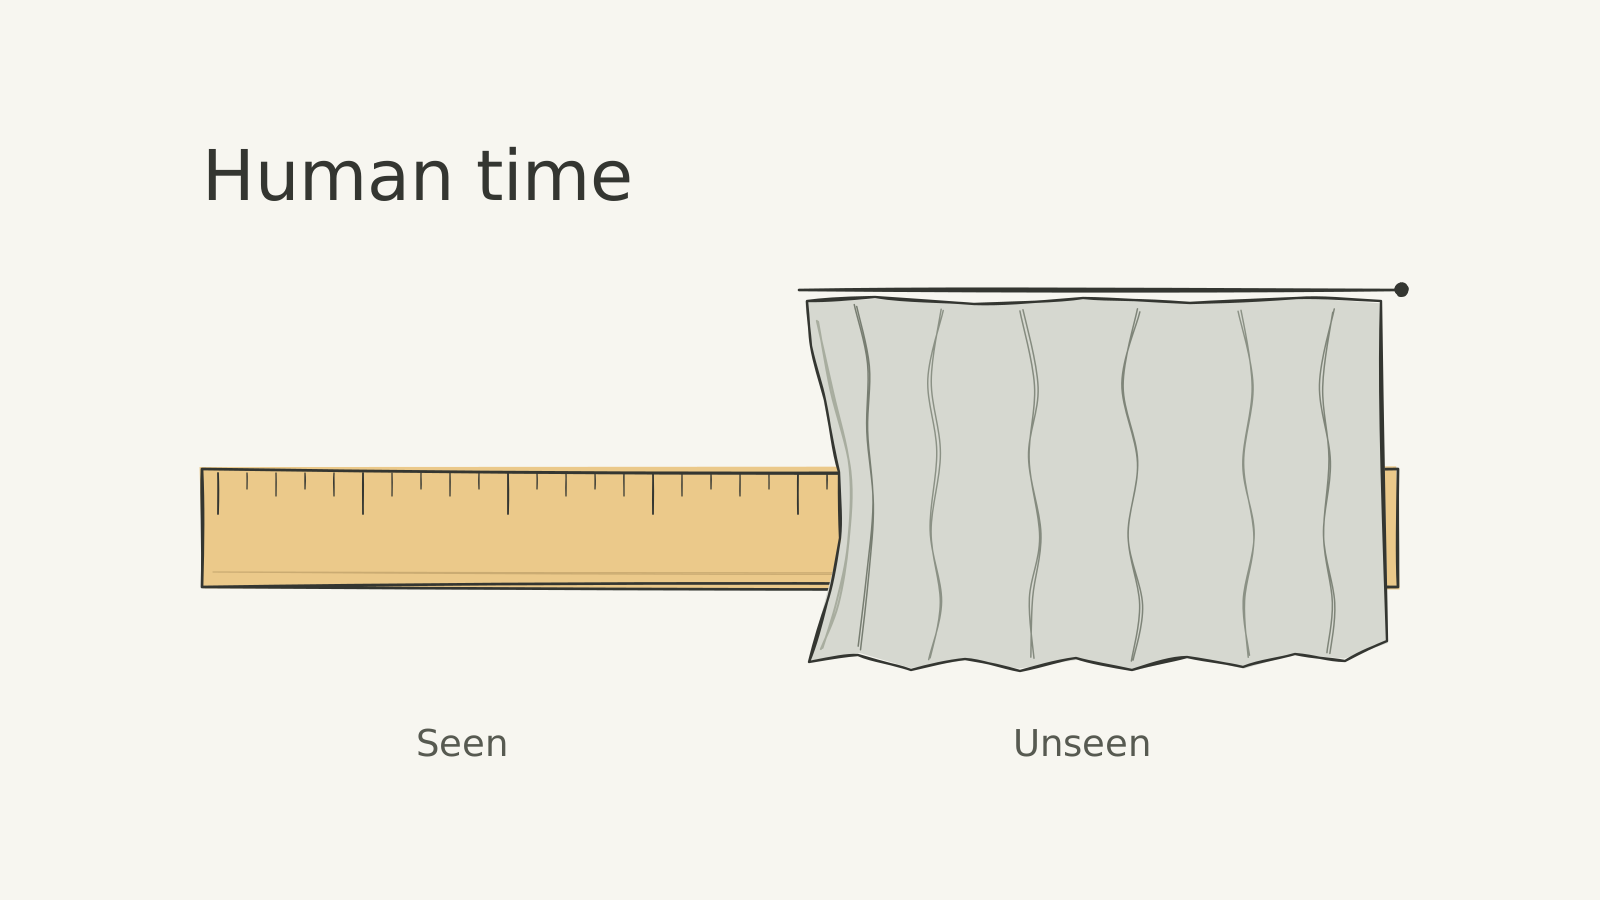
复杂的软件工程里,就有很多看不见的劳动。软件工程过去也拆分成前端、后端等各种分工,在各环节投入必要劳动时间,这一点和电影工程没什么两样。但它难以被大众理解,传播力就弱。一次数据迁移没丢东西,一次故障被容错接住,一个系统很久没出过事,这些都很重要,但它们很难让大众一眼看懂。
这些劳动可以通过降低成本、减少故障产生很高的经济效益,只是大众很难直接感受到,也就不容易传播。
工程智能足够高,人类可能是在捣乱
当然,这样论断也许有些武断,这确实是领域之间的区分,两种类型的问题在服务不同的目标函数。而在工程这一侧,事情会走得更远。
在某种效率或工程(engineer)领域中,随着 intelligence 的发展,假设有数百个 agent 由一个总导演在调度——结构上和电影工程几乎一样——而 agent 还要在不同的 human-in-the-loop 环节中去与人 align,你其实很难区分人类是否是在捣乱。
每一个 human-in-the-loop 环节,都要把上下文翻译给人听,再等人拍板;而人拍的板,又未必比 agent 自己的判断更好。
当 intelligence 达到足够的高度——agent 在具体任务上的判断已经强过大多数人,拿得到它需要的信息,做出来的东西也能被测试和验证——你会更希望整个过程全部由 agent 之间以更高效率的方式去沟通。
在这个前提下,我对 Astra 或者 Opus 5.5 之后的推演是:P95 以下的人类投入,可能都是在捣乱、拉低平均水平,很多工程实现甚至不如 agent 自身的工程直觉。这里的 P95 只是我对未来工程能力分布的估计,还没有对应的实测。
人类更多是在必要情况下补足现实社会的一些真实需求,或者通过 prompt、reference 和反馈,重新引导模型的 attention。说白了,就是把它的注意力拉回该看的地方。在执行已经足够可靠的部分,人还能提供的 align 可能微乎其微。在整个工程智能的投入分布上,人和 agent 的差距可能非常大。
但在游戏、电影这种过去由 studio 制作的艺术制品中,人类和 agent 的比例相对更加柔和、调和。因为在那边,人的感受、经验和选择,本身就是目标函数的一部分。